
Sam Altman : la RAM appartient aux centres de données, pas aux PC
Sam Altman soutient que l'inférence IA locale gaspille une RAM précieuse, tandis que la demande des centres de données stimule les contrats de mémoire, les pénuries et l'augmentation des coûts technologiques.
Par vrblogs.net
· 3 min de lecture
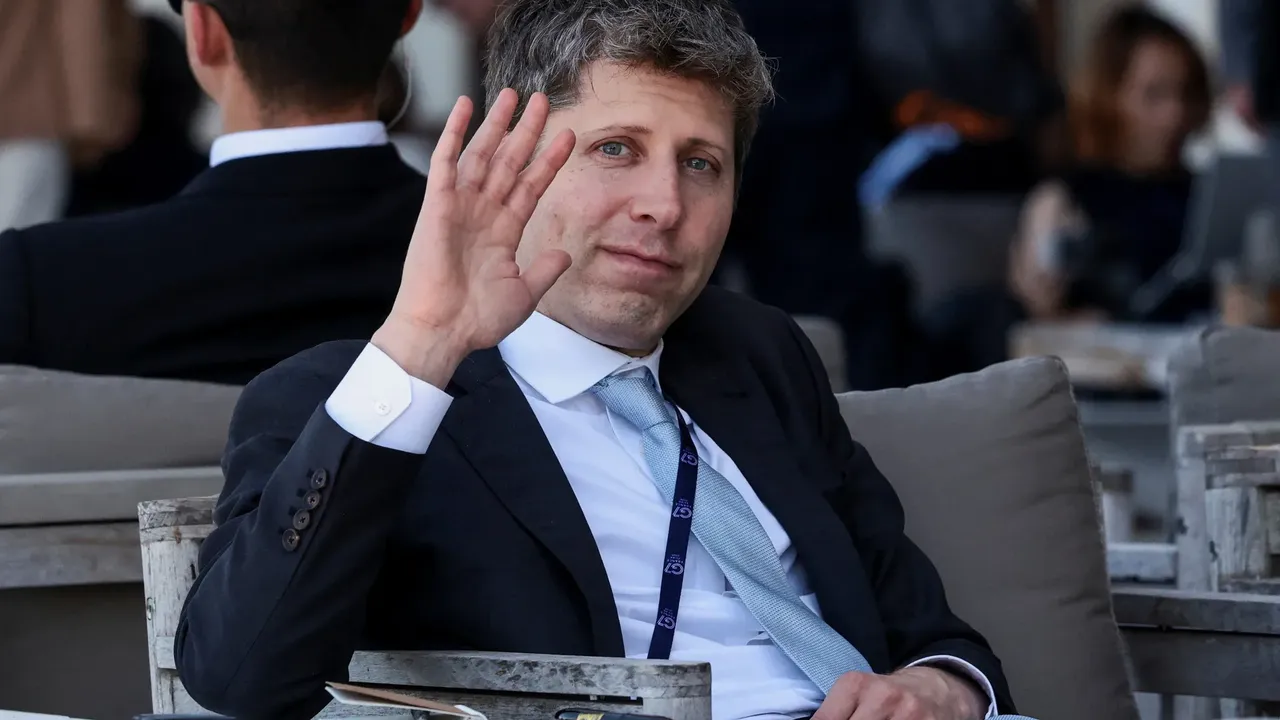
Sam Altman : « C'est dommage que la RAM soit dans l'ordinateur de l'utilisateur » résume l'argument d'OpenAI contre l'exécution de modèles IA en local. Le PDG de l'entreprise affirme que la mémoire rare devrait servir les centres de données plutôt que de rester inutilisée dans les ordinateurs personnels.
Altman a fait ces commentaires lors d'une interview avec la chaîne YouTube Cheeky Pint, publiée le 30 octobre. Il répondait à ceux qui voient les modèles open source fonctionnant sur des ordinateurs personnels comme un moyen de réduire la dépendance aux services cloud.
Pourquoi Altman s'oppose à l'inférence locale
L'inférence locale exécute un modèle IA entraîné directement sur un appareil. Le traitement peut utiliser du matériel tel que le CPU, le GPU ou le NPU d'un ordinateur ou d'un téléphone, plutôt que d'envoyer les données à des services cloud tiers comme ChatGPT et Claude.
Altman a fait valoir que l'IA locale laisse une grande partie de la mémoire disponible inutilisée. Il a déclaré que la RAM limitée est distribuée sur les ordinateurs des utilisateurs bien qu'elle ne soit utilisée que 5 % du temps. À son avis, la concentration de la mémoire dans les centres de données utiliserait mieux les ressources mondiales rares.
Sa position suppose que la construction et l'expansion des centres de données se poursuivront. Elle suppose également que la RAM fonctionnant en continu dans ces installations fournira plus de valeur que la mémoire installée dans les appareils des utilisateurs.
Le modèle commercial d'OpenAI est au cœur du débat
OpenAI a publié plusieurs modèles open source, mais son activité principale reste basée sur des modèles fermés exécutés dans des centres de données. Cela fait de l'inférence locale bien plus qu'un choix technique : cela pourrait affecter la manière dont les utilisateurs accèdent aux modèles IA et en payent l'utilisation.
Tom's Hardware a décrit les commentaires d'Altman comme une défense du modèle commercial d'OpenAI. Selon lui, les ordinateurs personnels ne menacent pas actuellement OpenAI, mais l'inférence locale pourrait réduire ce que les utilisateurs paient pour des modèles comme GPT-6 Luna.
Le différend couvre donc deux approches concurrentes. Les modèles locaux conservent le traitement sur le matériel des utilisateurs. Les modèles cloud placent l'informatique et la mémoire dans les centres de données appartenant au fournisseur, où les entreprises peuvent gérer la capacité partagée et facturer l'accès.
L'approvisionnement en mémoire crée de la pression
Les entreprises d'infrastructure IA signent des contrats à long terme pour sécuriser l'approvisionnement en mémoire. Micron a signé 26 accords stratégiques couvrant plus de 35 % de son chiffre d'affaires prévu d'ici 2030, avec 32 milliards de dollars en dépôts de clients confirmés.
Samsung finalisait apparemment des contrats couvrant 75–80 % de sa production de puces mémoire prévue d'ici 2027. SK Hynix poursuit également des accords similaires.
Ce cycle diffère des périodes antérieures de forte demande de puces. Les fabricants ont auparavant élargi les usines, puis ont fait face à une surproduction lorsque la demande a diminué. Cette fois, ils ont augmenté les prix plusieurs fois au lieu d'augmenter significativement la capacité, maintenant l'offre sous la demande et prolongeant la pression sur les prix.
Les analystes s'attendent à ce que la pénurie de puces mémoire dure au moins jusqu'en 2028. Cela donne aux fabricants un plus grand pouvoir de négociation tandis que les entreprises se concurrencent pour la production future.
Pourquoi les prix des ordinateurs comptent
Steve Bonifield de The Verge a déclaré que le résultat est similaire, que Altman ait parlé des ordinateurs personnels des utilisateurs ou des appareils utilisés par les développeurs d'applications IA. À son avis, les milliards de dollars dépensés par les entreprises pour les commandes de RAM contribuent à rendre les ordinateurs, téléphones et autres technologies plus chers.
L'argument rend cette actualité pertinente au-delà d'OpenAI. Elle relie l'IA locale, l'informatique en cloud, l'allocation de mémoire et les prix du matériel. Les lecteurs qui comparent les modèles locaux aux services cloud peuvent voir clairement le compromis : l'inférence locale utilise du matériel déjà possédé par les utilisateurs, tandis que l'inférence cloud concentre la demande dans les centres de données qui concourent maintenant agressivement pour la mémoire rare.
Vous avez aimé cet article ?
Aimez-le pour en informer la rédaction ou enregistrez-le pour le lire plus tard.
Commentaires
Connectez-vous pour participer à la conversation.
Se connecterAucun commentaire pour le moment. Lancez la conversation.
·