
Sam Altman: RAM gehört in Rechenzentren, nicht auf PCs
Sam Altman argumentiert, dass lokale KI-Inferenz knappe RAM-Ressourcen verschwendet, während die Nachfrage der Rechenzentren Speicherverträge, Engpässe und höhere Technologiekosten treibt.
Von vrblogs.net
· 2 Min. Lesezeit
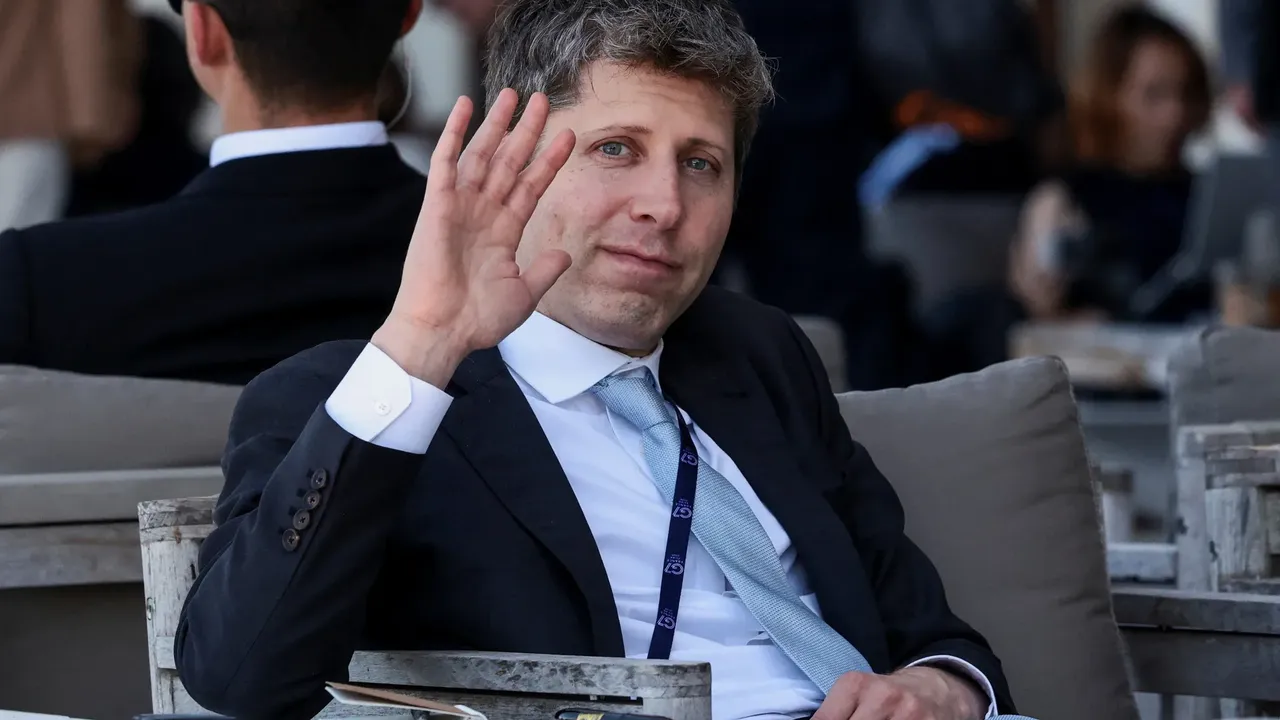
Sam Altman: „Es ist schade, dass RAM im Computer des Benutzers ist" fasst OpenAIs Argument gegen das lokale Ausführen von KI-Modellen zusammen. Der CEO des Unternehmens sagt, dass knappe Speicherkapazität Rechenzentren dienen sollte, statt ungenutzt in privaten Computern zu liegen.
Altman machte diese Aussagen in einem Interview mit dem YouTube-Kanal Cheeky Pint, das am 30. Oktober veröffentlicht wurde. Er antwortete auf Menschen, die Open-Source-Modelle auf privaten Computern als Möglichkeit sehen, die Abhängigkeit von Cloud-Diensten zu verringern.
Warum Altman lokale Inferenz ablehnt
Lokale Inferenz führt ein trainiertes KI-Modell direkt auf einem Gerät aus. Die Verarbeitung kann Hardware wie die CPU, GPU oder NPU eines Computers oder Telefons nutzen, anstatt Daten an Cloud-Dienste von Drittanbietern wie ChatGPT und Claude zu senden.
Altman argumentierte, dass lokale KI einen großen Teil des verfügbaren Speichers ungenutzt lässt. Er sagte, dass begrenzte RAM-Kapazität über Computer von Benutzern verteilt ist, obwohl sie nur zu 5 % der Zeit genutzt wird. In seiner Sicht würde die Konzentration von Speicher in Rechenzentren eine bessere Nutzung knapper globaler Ressourcen bedeuten.
Seine Position setzt voraus, dass der Bau und die Erweiterung von Rechenzentren anhalten werden. Sie geht auch davon aus, dass RAM, das kontinuierlich in diesen Einrichtungen läuft, mehr Wert bietet als Speicher, der auf Geräten von Benutzern installiert ist.
OpenAIs Geschäftsmodell steckt hinter der Debatte
OpenAI hat mehrere Open-Source-Modelle veröffentlicht, aber sein Kerngeschäft basiert weiterhin auf geschlossenen Modellen, die in Rechenzentren laufen. Das macht lokale Inferenz mehr als eine technische Wahl: Sie könnte beeinflussen, wie Benutzer auf KI-Modelle zugreifen und für sie bezahlen.
Tom's Hardware beschrieb Altmans Aussagen als Verteidigung von OpenAIs Geschäftsmodell. Die Sicht ist, dass private Computer derzeit OpenAI nicht bedrohen, aber lokale Inferenz könnte reduzieren, was Benutzer für Modelle wie GPT-6 Luna bezahlen.
Die Kontroverse umfasst daher zwei konkurrierende Ansätze. Lokale Modelle halten die Verarbeitung auf der Hardware von Benutzern. Cloud-Modelle platzieren Computing und Speicher in Rechenzentren im Besitz von Anbietern, wo Unternehmen gemeinsame Kapazitäten verwalten und für den Zugriff Gebühren erheben können.
Speicherangebot erhöht den Druck
KI-Infrastrukturunternehmen unterzeichnen langfristige Verträge, um Speicherlieferungen zu sichern. Micron hat 26 strategische Vereinbarungen unterzeichnet, die mehr als 35 % seiner prognostizierten Einnahmen bis 2030 abdecken, mit 32 Milliarden Dollar an zugesagten Kundeneinzahlungen.
Samsung schließt Berichten zufolge Verträge ab, die 75–80 % seiner geplanten Speicherchip-Produktion bis 2027 abdecken. SK Hynix verfolgt ebenfalls ähnliche Vereinbarungen.
Dieser Zyklus unterscheidet sich von früheren Phasen hoher Chip-Nachfrage. Hersteller haben früher Fabriken erweitert und waren dann mit Überangebot konfrontiert, wenn die Nachfrage abnahm. Diesmal haben sie stattdessen mehrmals Preise erhöht, anstatt die Kapazität erheblich zu erhöhen, halten das Angebot unter der Nachfrage und verlängern den Preisdruck.
Analysten erwarten, dass der Speicherchip-Mangel mindestens bis 2028 andauert. Das gibt Herstellern größere Verhandlungsmacht, während Unternehmen um künftige Produktion konkurrieren.
Warum Computerpreise wichtig sind
Steve Bonifield von The Verge sagte, das Ergebnis ist ähnlich, ob Altman die privaten Computer von Benutzern oder Geräte meinte, die von Entwicklern von KI-Anwendungen verwendet werden. In seiner Sicht helfen Milliarden von Dollar, die Unternehmen für RAM-Bestellungen ausgeben, Computer, Telefone und andere Technologien teurer zu machen.
Das Argument macht diese Nachricht relevant über OpenAI hinaus. Sie verbindet lokale KI, Cloud-Computing, Speicherzuteilung und Hardwarepreise. Leser, die lokale Modelle gegen Cloud-Services abwägen, können den Kompromiss klar sehen: Lokale Inferenz nutzt Hardware, die bereits von Benutzern besessen wird, während Cloud-Inferenz die Nachfrage in Rechenzentren konzentriert, die jetzt aggressiv um knappen Speicher konkurrieren.
Hat dir diese Story gefallen?
Gefällt sie dir? Zeige es der Redaktion oder speichere sie zum späteren Lesen.
Kommentare
Melde dich an, um an der Unterhaltung teilzunehmen.
AnmeldenNoch keine Kommentare. Starte die Unterhaltung.
·